בשעה טובה ומשמחת מאוד, גוגל שחררו לציבור API חדש בשם URL Inspection API. במקרה התמזל מזלי להיות חלק מהאלפא והבטא של ה-API הזה ומבחינתי הוא ממש גיים צ’יינג’ר בצורת ההתנהלות של אנשי SEO עם גוגל סרץ’ קונסול. Google: ההכרזה של Google על URL Inspection API
מה ה- Inspection API עושה?
נכון כל המידע שאתם יכולים לקבל כשאתם עושים Inspect URL ידני בסרץ’ קונסול? אני מתכוון למסך הזה:
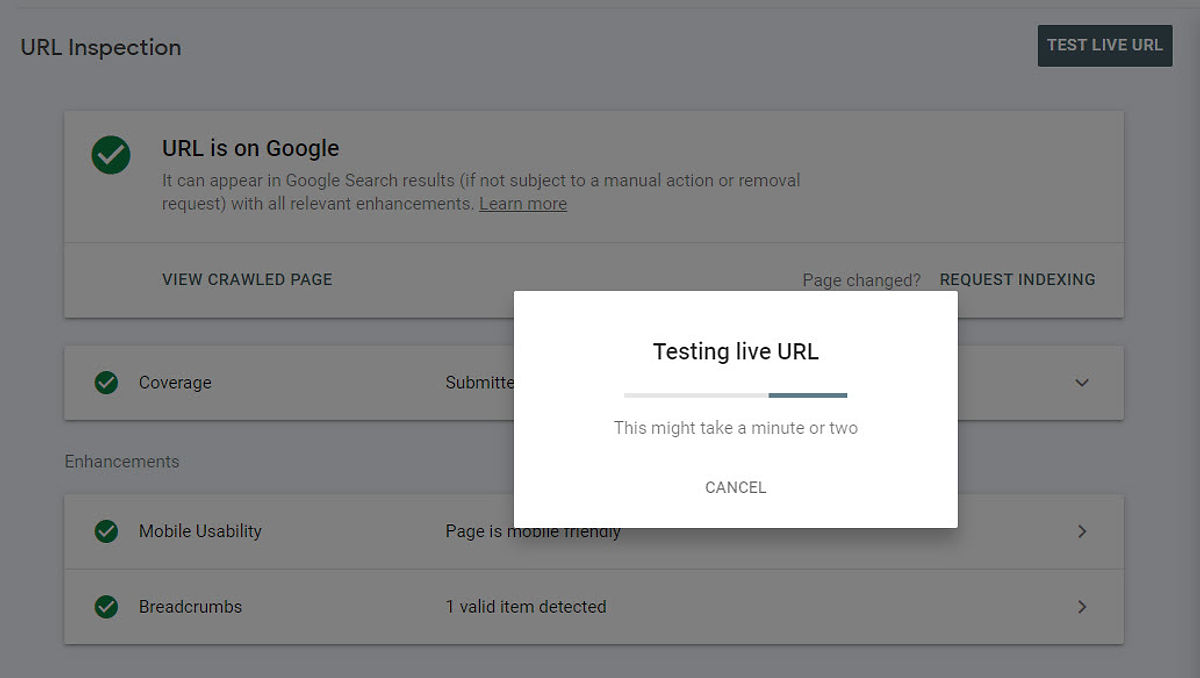
כל המידע המידע הזה עכשיו הוא זמין בצורת API, כלומר אתם או צד שלישי מטעמכם יכולים לשלוח קריאה עם ה-URL שאתם רוצים לבדוק ולקבל בחזרה המידע הזה מתוך הסרץ’ קונסול מבלי להיכנס ולבצע את הבדיקה ידנית עמוד עמוד. Google: המתודה index.inspect
חשוב: נכון לעכשיו, אין אפשרות לבקש אינדוקס של ה-URL, זהו API קריאה בלבד.
אין בשורה חדשה לגבי טיב המידע שאנחנו יכולים לקבל, זה אותו מידע שנקבל באמצעות ה-URL Inspection Tool רק שעכשיו אפשר לעשות את זה בסקייל/אוטומציה/באמצעות כלים וכו’. העיקר לא לעשות דברים בצורה ידנית כי זה לאיכרים. כמובן, שככל שמדובר באתר גדול יותר, כך התועלת שב-API גדולה יותר.
אני יכול לראות המון שימושים פוטנציאליים לזה, ביחוד עבור סוכנויות שרוצות ליעל את העבודה, או כלי SEO. אני משתמש ב-API הזה בצורה שוטפת כחלק מביקורות SEO טכניות שאני עושה לארגונים.
מכסות והגבלות
- ניתן לשלוח קריאה רק עבור נכסים שיש לכם גישה מספקת עבורם
- ניתן לשלוח עד 600 קריאות בדקה
- ניתן לשלוח עד 2000 קריאות ביום
איזה מידע מקבלים באמצעות ה-API?
התשובה שתקבלו בדמות JSON (דוקומנטציה כאן), מחולקת ל-4 קטגוריות/אובייקטים ותראה בערך כך: Google: התיעוד של UrlInspectionResult
{
  "inspectionResult": {
    "inspectionResultLink": "https://search.google.com/search-console/inspect?resource_id=https://developers.google.com/search/&id=odaUL5Dqq3q8n0EicQzawg&utm_medium=link&utm_source=api",
    "indexStatusResult": {
      "verdict": "PASS",
      "coverageState": "Indexed, not submitted in sitemap",
      "robotsTxtState": "ALLOWED",
      "indexingState": "INDEXING_ALLOWED",
      "lastCrawlTime": "2022-01-31T08:39:51Z",
      "pageFetchState": "SUCCESSFUL",
      "googleCanonical": "https://developers.google.com/search/help/site-appearance-faq",
      "userCanonical": "https://developers.google.com/search/help/site-appearance-faq",
      "referringUrls": [
        "https://developers.google.com/search/updates",
        "https://developers.google.com/search/help/crawling-index-faq"
      ],
      "crawledAs": "MOBILE"
    },
    "mobileUsabilityResult": {
      "verdict": "PASS"
    },
    "richResultsResult": {
      "verdict": "PASS",
      "detectedItems": [
        {
          "richResultType": "Breadcrumbs",
          "items": [
            {
              "name": "Unnamed item"
            }
          ]
        },
        {
          "richResultType": "FAQ",
          "items": [
            {
              "name": "Unnamed item"
            }
          ]
        }
      ]
    }
  }
}
סטטוס אינדוקס – indexStatusResult
המידע שתוכלו לקבל (ברמת ה-URL הספציפי) כולל, בין היתר:
- האם ה-URL ניתן לאינדוקס
- רשימת מפות האתר בהן ה-URL קיים
- סטטוס חסימה ב-robots.txt או noindex robots.txt robots.txt הוא קובץ טקסט שיושב בשורש האתר ומגדיר אילו כתובות סורקים רשאים לשלוף. robots.txt שולט בסריקה, לא באינדוקס. להגדרה המלאה של robots.txt noindex noindex הוא כלל שיושב בתגית meta או בכותרת HTTP ומשאיר עמוד מחוץ לאינדקס של מנועי החיפוש ומחוץ לתוצאות, וגם מחוץ ל-AI Overviews ול-AI Mode של גוגל, שנבנים מאותו אינדקס. להגדרה המלאה של noindex
- התאריך האחרון בו ה-URL נסרק על ידי גוגלבוט
- האם גוגל בחר את הדף הזה או אחר כקנוני
- הזחלן העיקרי איתו גוגל מגיע (מובייל או דסקטופ)
- שגיאות שגוגל מצא כשניסה לסרוק את ה-URL כמו חסימות ב robots.txt, שיאות 5xx, soft 404 וכו’. בגדול – אם גוגלבוט קיבל תגובה שהיא לא 200, זה יהיה פה
תוצאות עשירות – richResultsResult
כל הסכמות שגוגל זיהה בדף (וזכאיות לתוצאות עשירות בגוגל) ביחד עם שגיאות או אזהרות שנוגעות ל-markup. צפו לראות ברשימה רק מה שרלוונטי לפי גוגל ולא לפי schema.org כי זה לא גוגל.
נתונים על AMP – ampResult
במידה ואתם משתמשים ב-AMP באתר, תוכלו לקבל נתונים בסיסיים לגבי סטטוס אינדוקס של ה-AMP והאם הוא ניתן לאינדוקס. אין פה הרבה בשר.
שימושיות במובייל – mobileUsabilityResult
באובייקט הזה תקבלו את שגיאות ההתאמה למובייל שאנחנו מכירים מהכלים של גוגל, במידה ויש כאלה:
- בעיות viewport
- דפים רחבים מדי
- גדלי פונט בעיייתיים
- דברים שקרובים מדי אחד לשני
איך אפשר להתחיל להשתמש ב-URL Inspection API?
פשוט מאוד! לחכות. תנו לזה כמה ימים וכוחות השוק כבר יטפלו בזה, אני מכיר כמה וכמה כלים שעוד מעט משחררים אינטגרציה עם ה-API. במידה ואתם אתר שצריך פתרון יעודי, להתחיל מפה יעזור לכם המון.
יאללה, בהצלחה.