לברדור (Labrador) הוא אינדקס החיפוש של OpenAI עצמה, שממנו ChatGPT מביא חלק מתוצאות החיפוש שלו.
לפני שארחיב על לברדור, כדאי ליישר קו לגבי המונח אינדקס. אינדקס של מנוע חיפוש דומה למפתח בסוף ספר: הוא מסדר מראש את המידע על העמודים, כך שאפשר למצוא אותם לפי מה שהם עוסקים בו. כך המנוע מוצא בתוך שבריר שנייה את העמודים שעונים על שאלה, בלי לעבור על כל הרשת.
כדי לבנות את האינדקס, הסורק של המנוע מוריד מראש עמודים מהרשת. כלי AI שמחפש ברשת צריך אינדקס כזה, וזה מה ש-OpenAI בונה בלברדור.
עמוד יכול להיות במקום הראשון בגוגל ולא להופיע ב-ChatGPT בכלל, כי חלק מהתוצאות ש-ChatGPT מביא מגיעות מלברדור ולא מגוגל. אחרי שמבינים מאיפה ChatGPT מביא את התוצאות שלו, ברור יותר מה צריך לבדוק באתר.
מה זה לברדור, ואיך התגלה השם
השם לברדור הגיע מהנתונים שהשרתים של OpenAI שולחים לאתר של ChatGPT בזמן שהתשובה נכתבת. ליד כל תוצאת חיפוש היה שדה בשם result_source, שציין מאיפה היא הגיעה. הערכים שנמצאו בו היו labrador, bright, oxylabs ו-serp.
bright ו-oxylabs סימנו תוצאות של גוגל שהגיעו דרך חברות סקרייפינג, כלומר חברות שמריצות חיפושים בגוגל בשביל הלקוחות שלהן ומחזירות להם את דף התוצאות כנתונים. labrador סימן תוצאות מהאינדקס של OpenAI, ו-serp סימן חלק קטן מהתוצאות, ממקור שלא זוהה. הערכים האלה התגלו ביוני 2026, וב-21 ביולי 2026 OpenAI הסירה את השדה. מאז אי אפשר לראות בנתונים מאיפה הגיעה כל תוצאה. Suganthan: הניתוח של Suganthan Mohanadasan על השדה שמציין את מקור התוצאות ב-ChatGPT
מאיפה ChatGPT מביא תוצאות חיפוש
אפשר לדמיין מסעדה חדשה שבנתה לעצמה מטבח. מנות שהמטבח שלה עוד לא מכין מספיק טוב, היא מביאה מהמסעדה הוותיקה ממול. היא שולחת לשם שליח, שעומד בתור כמו כל לקוח וחוזר עם המנה בקופסה. המטבח הוא לברדור, המסעדה ממול היא גוגל, והשליחים הם חברות סקרייפינג.
בפועל, תוצאות החיפוש של ChatGPT מגיעות מכמה מקורות:
- לברדור, כלומר האינדקס של OpenAI עצמה.
- תוצאות של גוגל, שמגיעות ל-ChatGPT דרך חברות סקרייפינג.
- תוצאות של Bing. OpenAI עובדת גם עם מיקרוסופט, ותוצאות של Bing נמצאו רק בחלק מהמוצרים והחשבונות של ChatGPT.
- מקורות לתחומים מסוימים, כמו מוצרים מ-Shopify וזמינות של שולחנות במסעדות מ-OpenTable, מ-Resy או מ-Yelp.
ל-ChatGPT יש מצב Instant, שעונה מיד, ומצב Thinking, שחושב יותר זמן לפני שהוא עונה. המקור שישמש בכל תשובה תלוי בתוכנית, במצב ובשאלה.
ביולי 2026 רוב התוצאות בגרסה החינמית של ChatGPT, במצב Instant, הגיעו מלברדור, ורוב התוצאות במנוי בתשלום, במצב Thinking, הגיעו מגוגל. Resoneo: הניתוח של Resoneo על המקורות של תוצאות החיפוש ב-ChatGPT
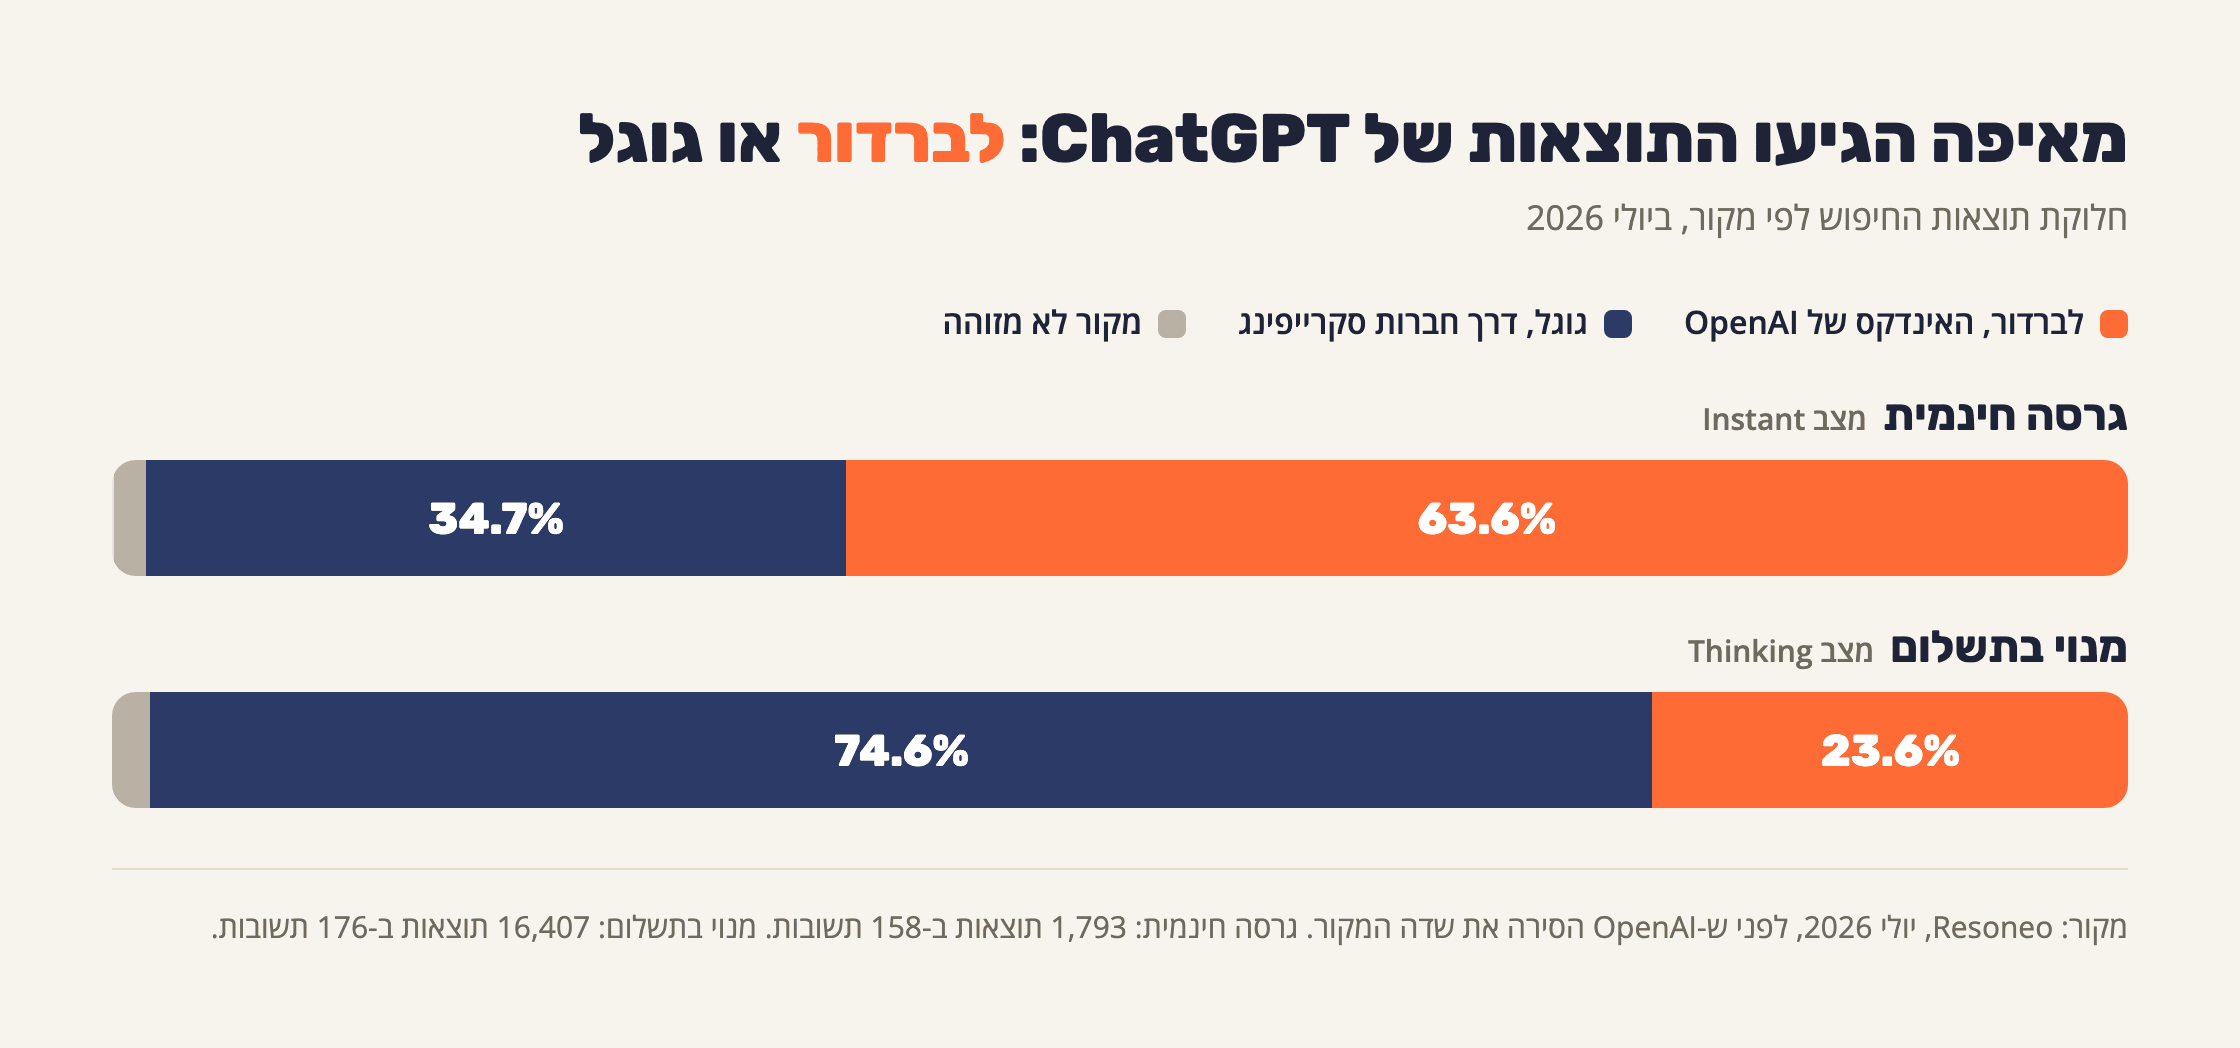
| תוכנית ומצב | לברדור (labrador) | גוגל דרך סקרייפינג (bright) | לא מזוהה (serp) | מדגם |
|---|---|---|---|---|
| גרסה חינמית, Instant | 63.6% | 34.7% | 1.6% | 1,793 תוצאות ב-158 תשובות |
| מנוי בתשלום, Thinking | 23.6% | 74.6% | 1.9% | 16,407 תוצאות ב-176 תשובות |
עם זאת, חצי מהשאלות במדגם עסקו בחדשות, והשיעורים תלויים מאוד במה ששואלים: בשאלות על מידע יציב, בגרסה החינמית, כמעט כל התוצאות הגיעו מלברדור.
רק חלק קטן מהעמודים ש-ChatGPT מצטט מופיעים בגוגל לאותה שאלה
אותו עמוד בדיוק ש-ChatGPT ציטט הופיע בעשרות התוצאות הראשונות של גוגל לאותה שאלה רק בכ-6% עד 10% מהמקרים. אותו אתר, גם אם בעמוד אחר, הופיע בכרבע עד כשליש מהמקרים. מחקר אחד בטבלה בדק את החיפושים ש-ChatGPT עצמו הריץ, כלומר את מניפת השאילתות שלו, ולא את השאלה המקורית.
| מחקר | מועד | מדגם | מה נמדד | תוצאה |
|---|---|---|---|---|
| Ahrefs | אוגוסט 2025, נתונים מיולי | כ-15,000 שאילתות ארוכות | אותו עמוד בעשר התוצאות הראשונות של גוגל | 8% מהציטוטים בגוף התשובה |
| Ahrefs | ספטמבר 2025 | 3,311 שאילתות קצרות | אותו עמוד ואותו אתר בתוצאות של גוגל | עמוד: 10% בעשר הראשונות, 20.69% במאה הראשונות. אתר: 31.8% ו-53.51% |
| Grow and Convert | עודכן במרץ 2026 | 100 שאילתות עם כוונת רכישה, ב-83 מהן ChatGPT חיפש | אותו עמוד בעשרת דפי התוצאות הראשונים של גוגל, לחיפושים ש-ChatGPT הריץ | 27%, וכ-40% בגוגל או ב-Bing |
| arXiv 2610.15382 | אוקטובר 2026, נתונים ממרץ עד יולי 2026 | 80 שאלות, 20 הרצות לכל אחת, ב-GPT-5.3 Instant וב-GPT-5.5 Instant | אותו עמוד ואותו אתר בכ-43 התוצאות של גוגל לשאלה המקורית | עמוד: 9.4% ו-6.4%. אתר: 26.1% ו-22.8%. מאמר שלא עבר ביקורת עמיתים |
| Profound | אוגוסט 2025 | מדגם מתוך 240 מיליון ציטוטים, גודלו לא פורסם | התאמה לגוגל, בלי הגדרה מפורסמת | עלייה מ-12% באפריל 2025 ל-33% ביולי 2025 |
השיטות במחקרים שונות זו מזו, ולכן אי אפשר לקרוא את הטבלה כמגמה לאורך זמן.
רק Profound מדדה באותה שיטה פעמיים, ומצאה דווקא עלייה בהתאמה לגוגל בין אפריל ליולי 2025. החפיפה הזו לא סותרת את ההערכה שלי שהתוצאות יתרחקו. לדעתי רובה מגיעה מהתוצאות ש-ChatGPT מביא מגוגל דרך סקרייפינג, כמו אלה שבמנוי בתשלום, וזו בדיוק הדרך שגוגל מקשה עליה.
מה צריך לעשות כדי ש-ChatGPT יוכל להוסיף את העמודים באתר לאינדקס
כדי שעמוד מהאתר יוכל להיכנס לאינדקס ש-ChatGPT מביא ממנו תוצאות, הסורק של OpenAI, OAI-SearchBot, צריך להגיע אליו ולקבל את התוכן שלו. אתר שחוסם את OAI-SearchBot כמעט לא מופיע בתשובות של ChatGPT. ארבעת הצעדים הבאים מוודאים שהסורק מגיע לעמודים, וזה תנאי לכניסה לאינדקס, אבל לא ערובה לה. OpenAI: התיעוד של OpenAI על הבוטים שלה
1. לאפשר ל-OAI-SearchBot גישה ב-robots.txt
לפתוח את קובץ robots.txt שבשורש הדומיין, למשל https://example.com/robots.txt, ולבדוק אילו הוראות חלות על OAI-SearchBot. אם יש בקובץ קבוצה שחוסמת כמה בוטים של AI יחד, היא יכולה להיראות כך: robots.txt robots.txt הוא קובץ טקסט שנמצא בשורש האתר ומגדיר אילו כתובות מותר לסורקים לסרוק. robots.txt שולט בסריקה, לא באינדוקס. להגדרה המלאה של robots.txt
User-agent: GPTBot
User-agent: OAI-SearchBot
Disallow: /
אם OAI-SearchBot מופיע בקבוצה כזו, צריך למחוק את השורה שלו, ו-GPTBot יכול להישאר חסום, כי הוא אוסף תוכן לאימון ולא לחיפוש. אם אין קבוצה שמזכירה את OAI-SearchBot, הוא מציית לקבוצת *. אם גם בה אין חסימה, הוא כבר מורשה לגשת ואין צורך לאשר אותו במפורש: הסורק יכול לסרוק כל עוד לא חוסמים אותו.
אם User-agent: * חוסם את כל האתר, צריך להוסיף קבוצה נפרדת ל-OAI-SearchBot ולהעתיק אליה את הנתיבים שצריכים להישאר חסומים. כתבתי על איך אפשר לחסום ולאפשר כל אחד מהבוטים של OpenAI ב-robots.txt. שינוי בקובץ יכול לקחת עד כ-24 שעות עד שיחול אצל OpenAI, בדומה לגוגל.
2. לאשר את OAI-SearchBot ב-CDN וב-WAF
לוודא שה-CDN, ה-WAF או מערכת ההגנה מבוטים של האחסון לא חוסמים את OAI-SearchBot. אלה שכבות שמסננות בקשות לפני שהן מגיעות לאתר, והרשאה ב-robots.txt לא עוקפת אותן. באתר שעובר דרך Cloudflare צריך לבדוק ב-Security > Settings, תחת AI Crawler and Agent access policies, שבוטי החיפוש לא חסומים.
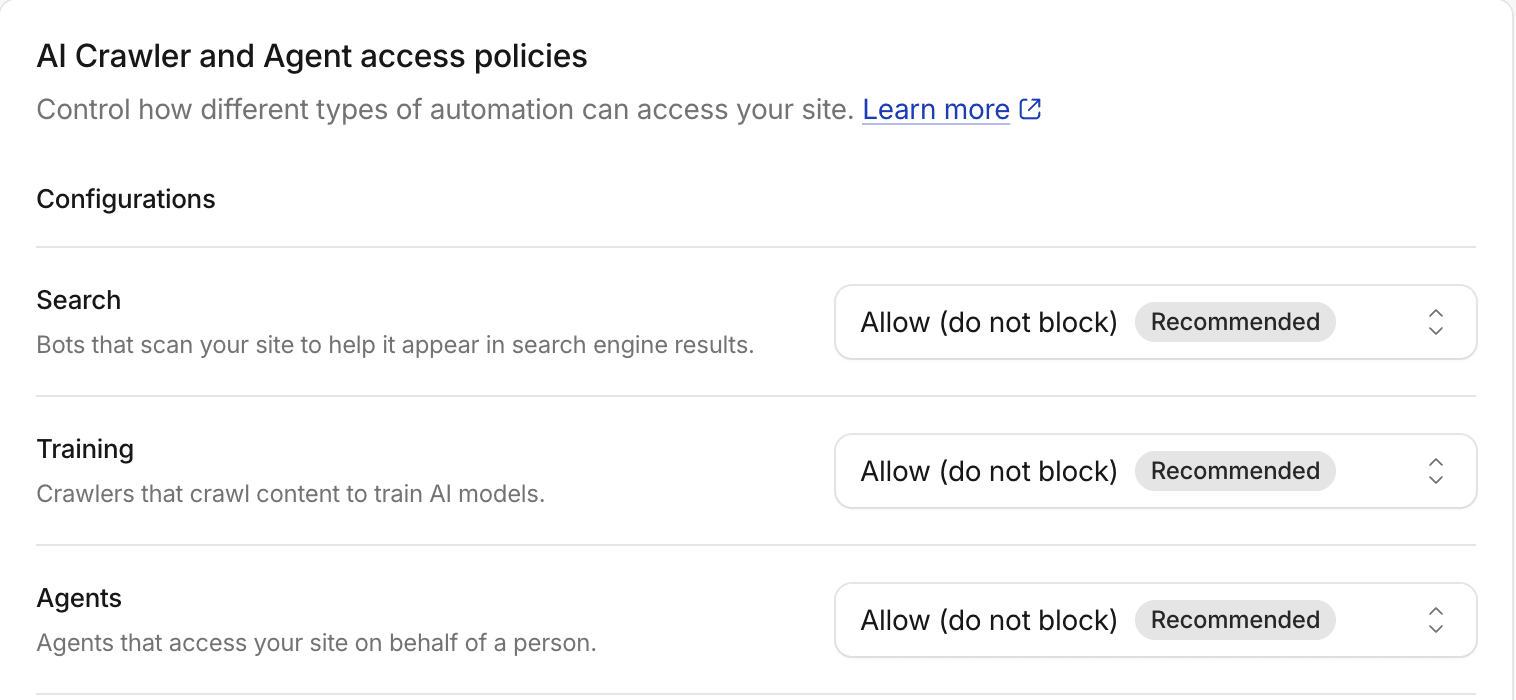
ב-AI Crawl Control של Cloudflare אפשר גם לחסום כל סורק בנפרד, ולכן כדאי לוודא שם ש-OAI-SearchBot עצמו לא חסום. בכלים אחרים צריך לאשר את טווחי ה-IP של OAI-SearchBot, ולא רק את השם שלו, כי כל אחד יכול להזדהות בשם הזה. הרשימה משתנה מדי פעם, ולכן כדאי לעדכן אותה. OpenAI: טווחי ה-IP של OAI-SearchBot
3. להגיש את התוכן ב-HTML שהשרת מחזיר
לוודא שהתוכן החשוב נמצא ב-HTML שהשרת מחזיר. הסורקים של OpenAI לא מריצים JavaScript, ולכן תוכן שנבנה רק ב-JavaScript אחרי שהעמוד נטען לא מגיע אליהם. הפתרון הנפוץ הוא רינדור בצד שרת (SSR): השרת בונה את העמוד המלא ושולח אותו מוכן, כך שהתוכן נמצא ב-HTML כבר בבקשה הראשונה. איך בודקים מה השרת מחזיר, ומה האפשרויות לתקן, הסברתי במדריך ל-SSR. רינדור בצד שרת רינדור בצד שרת (SSR) הוא גישה שבה השרת בונה את ה-HTML של העמוד בכל בקשה, במקום שהדפדפן יבנה את העמוד ב-JavaScript. להגדרה המלאה של רינדור בצד שרת
4. לבדוק בלוגים של השרת ושל ה-CDN שהסורק מגיע לעמודים
נכון לנובמבר 2026 אין ל-OpenAI מקום להגיש מפת אתר או כתובת, ואין לה כלי לבעלי אתרים בסגנון Search Console. לכן הלוגים של השרת וה-CDN הם המקום לבדוק אם הסורק מגיע לעמודים.
אחרי יום או יומיים, לחפש בקשות של OAI-SearchBot בלוגים של השרת ולקרוא את קוד התגובה. באתר שעובר דרך CDN, כמו Cloudflare או Akamai, כדאי להתחיל דווקא בלוגים של ה-CDN, ובאתר הזה אני מנטר את החסימות דרך Cloudflare. בקשות שה-CDN חסם לא מגיעות לשרת, ובלוגים של השרת מופיעה לפעמים הכתובת של ה-CDN במקום הכתובת של הסורק.
אני רואה לא מעט בוטים שמתחזים לבוטים של OpenAI, ולכן חשוב לראות שהבקשה מאומתת. Cloudflare עושה את זה בעצמה ומסמנת בקשות של בוטים מוכרים, כמו OAI-SearchBot, כ-Verified Bot. בלי CDN כזה, צריך לבדוק אם כתובת המקור נמצאת בתוך אחד מטווחי ה-IP של הסורק, ולא לחפש אותה כטקסט.
כך אפשר לקרוא את מה שמופיע בלוגים:
- בקשות מאומתות שקיבלו
200לעמודים עצמם, ולא רק ל-/robots.txt: הסורק מגיע לעמודים. אם מה שהוחזר הוא עמוד התחברות ולא התוכן, הוא לא מקבל את התוכן. זה עדיין לא מוכיח שהעמוד נכנס לאינדקס. - בקשות שקיבלו
403,429או עמוד בדיקה: השרת או ה-CDN חוסמים את הסורק, וצריך לחזור לצעד 2. - אין בקשות בכלל: ייתכן שה-CDN חוסם את הסורק, ואז הבקשות יופיעו רק בלוגים של ה-CDN. ייתכן גם שהסורק עוד לא הגיע לעמודים, למשל כשהם חדשים או שאין אליהם קישורים מעמודים אחרים.
- רק בקשות של
ChatGPT-User: הן לא נחשבות כאן. ChatGPT-User קורא עמודים בעקבות בקשה של משתמש, ו-OpenAI לא משתמשת בו כדי להחליט מה יופיע בחיפוש. - בקשה שמזדהה כ-OAI-SearchBot מכתובת שלא נמצאת בטווחים: מישהו מתחזה לסורק, והבקשה לא מלמדת דבר על OpenAI.
למה עמוד שהסורק מגיע אליו עדיין חסר באינדקס
גם אחרי שהסורק מגיע לאתר, עמוד יכול להיעדר מהאינדקס של OpenAI או להופיע בו בגרסה ישנה. חוץ מהחסימות שבצעדים 1 עד 3, יש לזה שלוש סיבות נפוצות:
- העמוד פתוח רק למשתמשים מחוברים. הסורק לא מתחבר לאתר, ולכן הוא לא רואה את התוכן. עמוד שאמור להופיע בתוצאות צריך להיות פתוח לכולם.
- אף עמוד אחר באתר לא מקשר אליו. הסורק מוצא עמודים חדשים דרך קישורים, ולכן קישור מעמוד שהוא כבר מגיע אליו עוזר לו למצוא את העמוד.
- העמוד חדש, או שכמעט לא מבקרים בו. מתי OpenAI תסרוק עמוד שוב תלוי גם בפופולריות שלו, ואין לזה מועד קבוע. לכן גם עמוד תקין יכול להופיע בגרסה ישנה לזמן מה, ולסיבה הזו אין פתרון מהיר.
למה OpenAI עדיין צריכה את גוגל
לגוגל היו יותר מ-20 שנה לבנות את האינדקס שלה. OpenAI עדיין בונה את שלה, ולדעתי הוא קטן יותר ופחות עדכני. לכן היא עדיין צריכה מקורות חיצוניים, ובראשם התוצאות של גוגל.
בעיות איכות אצל ספקי חיפוש אחרים, לא גוגל, שסיפקו ל-OpenAI תוצאות חיפוש, הן שהביאו אותה לבנות אינדקס משלה. היא גם ביקשה מגוגל שותפות לביסוס תשובות, כלומר גישה מסודרת לתוצאות של גוגל, שהמודל קורא לפני שהוא עונה ונשען עליהן בתשובה. CourtListener: ההחלטה על הסעדים בתיק ההגבלים העסקיים נגד גוגל
ניק טרלי, ראש ChatGPT ב-OpenAI, העיד באפריל 2025 ש-OpenAI קיוותה לענות על 80% מהחיפושים מהאינדקס שלה עד סוף 2025, ואמר שהיעד הזה רחוק עכשיו עוד כמה שנים. Courthouse News: הדיווח של Courthouse News מהעדות של ניק טרלי
סביר בעיניי שעבור OpenAI זול יותר להגיש תוצאה מהאינדקס שלה מאשר לקנות אותה מחברת סקרייפינג. אם במנוי בתשלום היא עדיין נשענת בעיקר על גוגל, אני קורא את זה כך: לברדור זול יותר, אבל עדיין לא מספיק טוב.
איך גוגל חוסמת את הסקרייפרים ש-ChatGPT נשען עליהם
מאז ינואר 2025 גוגל מוסיפה צעדים שמקשים על הורדה אוטומטית של דפי התוצאות שלה:
- ינואר 2025: גוגל התחילה לדרוש JavaScript כדי להציג תוצאות חיפוש, כדי להגן על השירות מבוטים ומספאם.
- ינואר 2025: גוגל הפעילה את SearchGuard, מערכת שנועדה לחסום הורדה אוטומטית של התוצאות: היא מזהה בקשות ממקורות לא מוכרים ושולחת להן מבחן JavaScript.
- ספטמבר 2025: הפרמטר
num=100הפסיק לעבוד. הוא אפשר לכלים לקבל 100 תוצאות בבקשה אחת, ומאז כלי שרוצה 100 תוצאות צריך עשר בקשות. באוקטובר 2026 הוא הופיע שוב בחלק מהחיפושים. - ספטמבר עד אוקטובר 2026: כלים למעקב אחרי דירוגים בגוגל דיווחו על חסימות, על בדיקות CAPTCHA ועל תוצאות מעוותות.
בדצמבר 2025 גוגל גם תבעה את SerpApi, חברה שמוכרת גישה לתוצאות של גוגל, בטענה שהיא עוקפת את SearchGuard. ב-20 ביולי 2026 בית המשפט דחה את התביעה, אבל התיר לגוגל לתקן אותה, וגוגל הגישה תביעה מתוקנת באוגוסט. נכון לתחילת נובמבר 2026 לא דווח על החלטה בתביעה המתוקנת.
התביעה לא עוסקת ב-AI או ב-OpenAI, אבל SerpApi הייתה אחת החברות ש-OpenAI קיבלה דרכן תוצאות של גוגל. Search Engine Roundtable: הדיווח על השימוש של OpenAI בתוצאות של גוגל דרך SerpApi
למה אני צופה שהתוצאות של ChatGPT ושל גוגל יתרחקו עם הזמן
ל-OpenAI אין הרבה ברירה. בדימוי של המסעדה מתחילת המדריך, המטבח הוא לברדור, והשליחים הם חברות הסקרייפינג שמביאות את המנות מגוגל. אם לשליחים יהיה קשה יותר להגיע למסעדה הוותיקה, המסעדה החדשה תצטרך לבשל יותר מנות במטבח שלה.
אני מעריך שהתוצאות של ChatGPT ושל גוגל ילכו ויתרחקו. בגרסה החינמית רוב התוצאות שנמדדו כבר הגיעו מלברדור. הדרך לתוצאות של גוגל דרך סקרייפינג לא נסגרת, אבל היא רצופה קשיים, וכנראה תהיה יקרה וקשה יותר לביצוע בהיקפים גדולים, ול-OpenAI זול יותר להגיש תוצאות מהאינדקס שלה. לכן סביר בעיניי ש-ChatGPT ישתמש בלברדור יותר ויותר, גם במנוי בתשלום.
באמצע אוגוסט 2026 רץ בתחום הקניות של ChatGPT ניסוי בשם prefer-index-over-serp-v3, והוא חל באותו זמן על 8% מהשיחות. שם הניסוי מתאר העדפה של האינדקס על פני תוצאות חיפוש חיצוניות. Peec AI: הניתוח של Peec AI על האינדקס ש-ChatGPT בנה
גם הפיילוט של Cloudflare ו-OpenAI, שעזר לסורק של OpenAI לגלות מאות מיליוני עמודים חדשים, הוא בעיניי סימן ש-OpenAI משקיעה בהרחבת האינדקס שלה.
התהליך לא יהיה מהיר. באוגוסט 2026, כשהמקור כבר זוהה רק לפי הצורה של התוצאות, כ-75% מהתוצאות במנוי בתשלום, במצב Thinking, עדיין הגיעו מגוגל. ובאפריל 2025 טרלי העיד שהיעד של 80% מהחיפושים מהאינדקס של OpenAI רחוק עוד כמה שנים.
למי שעובד על נראות ב-ChatGPT, הגישה של OAI-SearchBot לאתר היא תנאי להופעה בכל תשובות החיפוש של ChatGPT, גם בתוצאות שמגיעות מגוגל. אחרי שהגישה פתוחה, דירוג טוב בגוגל עוזר להופיע בחלק של התוצאות ש-ChatGPT עדיין מביא מגוגל, ולדעתי החלק הזה ילך ויקטן עם הזמן, כנראה לא לגמרי.
בהצלחה.